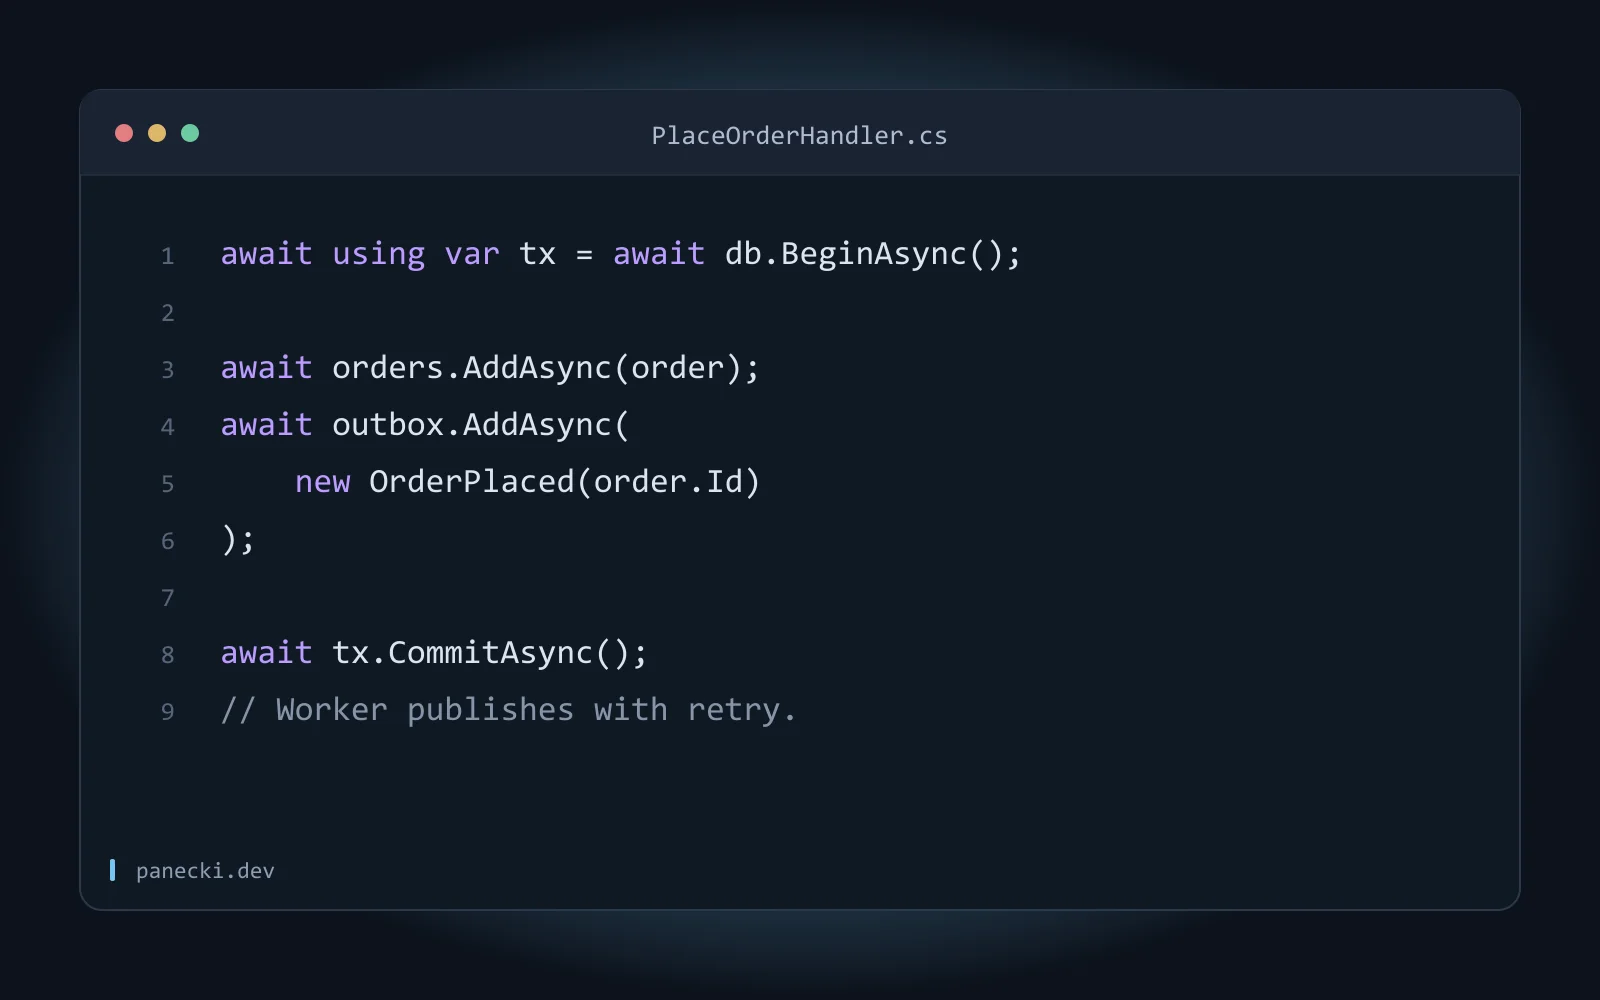
Zamówienie zostało zapisane, ale magazyn nie dostał wiadomości o rezerwacji. W bazie wszystko wygląda poprawnie, broker działa, a proces zakupowy stoi. Aplikacja zakończyła pracę dokładnie pomiędzy zatwierdzeniem transakcji a publikacją zdarzenia.
Transactional Outbox pozwala zapisać zmianę biznesową i zamiar wysłania wiadomości w jednej lokalnej transakcji. Osobny proces realizuje wysyłkę. Rozwiązanie wymaga jednak czegoś więcej niż tabeli outbox: trzeba rozstrzygnąć ponowienia, duplikaty, przejmowanie pracy po awarii i sposób wykrywania zablokowanych wiadomości.
Dwa zapisy i szczelina między nimi
Załóżmy, że operacja SubmitOrder zapisuje zamówienie w SQL i publikuje OrderSubmitted do brokera. Przy zwykłej transakcji bazy nie da się objąć nią obu systemów:
- Najpierw baza, potem broker: po zatwierdzeniu zamówienia proces może zakończyć się przed wysyłką. Zamówienie istnieje, lecz magazyn o nim nie wie.
- Najpierw broker, potem baza: magazyn może rozpocząć realizację, mimo że transakcja zamówienia została wycofana.
- Publikacja wewnątrz otwartej transakcji: wysłanej wiadomości nie cofnie późniejszy rollback SQL. Dodatkowo blokady w bazie czekają na odpowiedź sieci.
Samo przestawienie instrukcji ani obsłużenie wyjątku nie zamyka tej szczeliny. Proces może zostać przerwany bez wykonania catch. Potrzebny jest trwały zapis pracy, którą można podjąć po restarcie.
Co zapisuje Outbox i co właściwie gwarantuje
- Transakcja zapisuje stan zamówienia oraz rekord wiadomości w tej samej bazie.
- Po zatwierdzeniu worker odczytuje oczekujące rekordy i publikuje je do brokera.
- Po wymaganym potwierdzeniu brokera worker oznacza wiadomość jako wysłaną.
- Jeżeli worker zakończy pracę wcześniej, rekord pozostaje do ponownego przetworzenia.
Atomowa jest para zmiana danych + zapis wiadomości. Publikacja następuje później. Outbox nie gwarantuje, że odbiorca wykona operację natychmiast ani że efekt u odbiorcy będzie atomowy ze zmianą zamówienia. Awaria brokera może opóźnić cały proces biznesowy.
Broker może przyjąć wiadomość, po czym worker zakończy pracę przed oznaczeniem jej w bazie. Kolejna próba wyśle tę samą wiadomość ponownie. Dlatego projektuj dostarczanie co najmniej raz i idempotentną obsługę.
Ta gwarancja zakłada trwałe przechowywanie danych, poprawną konfigurację brokera i możliwość dalszych ponowień. Po wyczerpaniu limitu prób wiadomość nadal wymaga naprawy albo świadomego rozstrzygnięcia przez operatora. Wzorzec i jego ograniczenia opisuje Transactional Outbox w katalogu Microservices.io.
Zapis zamówienia i wiadomości w EF Core
Poniższy fragment zakłada relacyjną bazę, jeden DbContext oraz encję OutboxMessage mapowaną na tabelę outboxa. Agregat został wcześniej pobrany z kontrolą uprawnień, a Submit() sprawdza reguły i zwiększa wersję zamówienia. Obsługa konfliktów współbieżności i mapowanie encji są pominięte.
public sealed record OrderSubmittedV1(
    Guid OrderId,
    Guid CustomerId,
    long Version);

var now = DateTimeOffset.UtcNow;
var messageId = Guid.NewGuid();

await using var transaction =
    await db.Database.BeginTransactionAsync(ct);

order.Submit();

db.OutboxMessages.Add(new OutboxMessage
{
    MessageId = messageId,
    AggregateId = order.Id,
    AggregateVersion = order.Version,
    Type = "order.submitted.v1",
    Payload = JsonSerializer.Serialize(new OrderSubmittedV1(
        order.Id, order.CustomerId, order.Version)),
    OccurredAtUtc = now,
    AvailableAtUtc = now
});

await db.SaveChangesAsync(ct);
await transaction.CommitAsync(ct);
Oba zapisy muszą korzystać z tej samej transakcji. Jeżeli tabela outboxa znajduje się w innej bazie albo zapisujesz ją przez niezależne połączenie, ten przykład traci swoją podstawową gwarancję. Samo nazwanie metody SaveWithOutbox nie tworzy atomowości.
Przy jednym SaveChanges relacyjny provider EF Core standardowo obejmuje zmiany transakcją; jawna transakcja w przykładzie pokazuje granicę i przydaje się, gdy operacja wymaga kilku zapisów. Przy włączonych strategiach ponawiania błędów przejściowych trzeba skoordynować z nimi całą jednostkę pracy. Szczegóły omawia dokumentacja transakcji EF Core.
MessageId identyfikuje trwały rekord i pozostaje taki sam podczas kolejnych prób publikacji. Nie losuj nowego identyfikatora przy każdej wysyłce. Osobno rozwiąż ponowienie samej komendy HTTP po utracie odpowiedzi: klucz idempotencji operacji biznesowej powinien zapobiec utworzeniu drugiego zamówienia i drugiej wiadomości dla tej samej intencji.
Jakie dane powinny znaleźć się w rekordzie
Outbox przechowuje komunikat gotowy do późniejszej publikacji: identyfikator, typ i wersję kontraktu, payload, czas zdarzenia oraz dane routingu. Do obsługi workera przydają się również: najwcześniejszy termin próby, licznik prób, token przejęcia, termin ważności przejęcia, data publikacji i zwięzła informacja o ostatnim błędzie.
Zapisz payload podczas transakcji biznesowej. Odtwarzanie go dopiero podczas wysyłki z aktualnego stanu zamówienia może zmienić znaczenie dawnego zdarzenia. Przekazuj dane potrzebne odbiorcy, unikając sekretów i niepotrzebnych danych osobowych. Kontrakt integracyjny powinien mieć jawny schemat; nazwa klasy CLR i jej pełna serializacja mocno wiążą odbiorców z implementacją nadawcy.
Wielu workerów: krótkie przejęcie zamiast długiej blokady
Proste SELECT ... WHERE published_at IS NULL pozwoli kilku workerom pobrać te same rekordy jednocześnie. Duplikaty nadal są dozwolone, ale niepotrzebna równoległa wysyłka zwiększa obciążenie. Worker powinien atomowo przejąć niewielką porcję pracy.
W PostgreSQL można użyć FOR UPDATE SKIP LOCKED i czasowego przejęcia, czyli lease. Poniższy SQL zakłada tabelę outbox_messages z kolumnami odpowiadającymi opisanym wyżej polom. :claim_token jest nowym UUID dla tego przejęcia, przekazywanym jako parametr.
WITH candidates AS (
    SELECT message_id
    FROM outbox_messages
    WHERE published_at IS NULL
      AND available_at <= now()
      AND (lease_until IS NULL OR lease_until <= now())
    ORDER BY occurred_at, message_id
    LIMIT 50
    FOR UPDATE SKIP LOCKED
)
UPDATE outbox_messages AS o
SET lease_token = :claim_token,
    lease_until = now() + interval '30 seconds',
    attempts = attempts + 1
FROM candidates AS c
WHERE o.message_id = c.message_id
RETURNING o.*;
Całe przejęcie zatwierdź przed rozpoczęciem komunikacji z brokerem. Blokady wierszy są wtedy krótkie, a lease pozwala innemu workerowi podjąć pracę po awarii. Dokumentacja PostgreSQL opisuje SKIP LOCKED jako mechanizm przydatny między innymi dla tabel obsługiwanych jak kolejka. Dla SQL Server lub innego silnika dobierz właściwy mechanizm blokad i sprawdź go pod współbieżnym obciążeniem.
Rozmiar porcji i 30 sekund są przykładowe. Jeśli wysyłasz 50 wiadomości kolejno przez wolne połączenie, lease może wygasnąć przed końcem porcji. Ogranicz porcję i czas operacji, a w razie potrzeby odnawiaj przejęcie. Worker, który utracił przejęcie, powinien zaprzestać dalszej pracy nad rekordem.
Kiedy można oznaczyć wiadomość jako wysłaną
Metoda PublishAsync może zakończyć się już po zapisaniu danych do lokalnego bufora klienta. Sprawdź, co faktycznie oznacza jej sukces. W RabbitMQ publisher confirms dotyczą przyjęcia publikacji przez broker i są osobnym mechanizmem od potwierdzeń konsumenta. Trwałość kolejek i wiadomości oraz wykrywanie wiadomości bez trasy również wymagają właściwej konfiguracji.
Po wymaganym potwierdzeniu publikacji aktualizuj rekord warunkowo:
UPDATE outbox_messages
SET published_at = now(),
    lease_token = NULL,
    lease_until = NULL
WHERE message_id = :message_id
  AND lease_token = :claim_token
  AND published_at IS NULL;
Sprawdź liczbę zmienionych wierszy. Zero może oznaczać utratę przejęcia. Ten sam warunek tokenu powinien chronić zapis błędu, odnowienie lease i zaplanowanie kolejnej próby, aby spóźniony worker nie nadpisał pracy nowego właściciela.
Token zabezpiecza aktualizację w SQL, ale nie cofnie publikacji starego workera, jeśli jego żądanie sieciowe było już w drodze. Awaria po przyjęciu wiadomości przez broker i przed aktualizacją outboxa również pozostawia niepewność. W obu przypadkach kolejna próba może dostarczyć duplikat.
Idempotentny konsument i trwały Inbox
Wyobraź sobie konsumenta, który po OrderSubmitted tworzy lokalne zlecenie wysyłki. Jeśli sprawdza przetworzone identyfikatory tylko w pamięci, restart usuwa tę wiedzę. Jeśli zapisuje identyfikator i efekt w osobnych transakcjach, awaria pomiędzy nimi znowu tworzy szczelinę.
Typowy Inbox to tabela z unikalnym kluczem (consumer_id, message_id). Identyfikator konsumenta rozróżnia niezależne subskrypcje: rozliczenia i magazyn muszą móc przetworzyć tę samą wiadomość. W obrębie jednego konsumenta kolejne dostarczenia korzystają z tego samego klucza.
- Otwórz transakcję w bazie odbiorcy.
- Spróbuj wstawić identyfikator do Inboxa z ochroną unikalności, na przykład
INSERT ... ON CONFLICT DO NOTHINGw PostgreSQL. - Jeśli rekord już istnieje, zakończ transakcję i potwierdź wiadomość bez ponownego wykonywania efektu.
- Jeśli rekord jest nowy, wykonaj lokalną zmianę biznesową w tej samej transakcji i zatwierdź oba zapisy.
- Dopiero po zatwierdzeniu potwierdź odbiór wiadomości brokerowi.
Przy błędzie zmiany biznesowej cała transakcja musi zostać wycofana, również wpis Inboxa. Unikalność w bazie chroni przed dwoma konsumentami przetwarzającymi ten sam identyfikator równocześnie. Sekwencja „sprawdź przez SELECT, potem wstaw” bez odpowiedniej ochrony pozostawia wyścig.
Jeśli odbiorca zatwierdzi zmianę, ale zakończy pracę przed potwierdzeniem brokerowi, wiadomość wróci. Trwały Inbox pozwoli rozpoznać powtórkę. Dodatkowe ograniczenia biznesowe, na przykład jedno zlecenie wysyłki na zamówienie, chronią też przed różnymi wiadomościami opisującymi tę samą operację.
Płatność lub e-mail wymagają kolejnej granicy
Transakcja Inboxa nie obejmie automatycznie operatora płatności ani usługi pocztowej. Jeśli pobierzesz pieniądze i proces zakończy pracę przed zapisem lokalnym, następna próba może pobrać je ponownie. Zapisz trwałe zlecenie efektu, używaj stabilnego klucza idempotencji obsługiwanego przez dostawcę i zapewnij możliwość sprawdzenia wyniku operacji.
Jeżeli dostawca nie oferuje idempotencji ani odczytu stanu, ryzyka duplikatu nie da się usunąć samym wpisem w lokalnej tabeli. Trzeba określić sposób uzgadniania wyniku i ewentualnej kompensacji. Granice odpowiedzialności procesu są szerzej omówione w artykule Kiedy Aggregate Root to za mało.
Kolejność wiadomości wymaga osobnej decyzji
ORDER BY occurred_at w zapytaniu workera nie gwarantuje kolejności dostarczenia. Jeden worker może wolniej publikować starszy rekord, podczas gdy drugi przejmie i wyśle nowszy. SKIP LOCKED dodatkowo pozwala ominąć zablokowany wiersz.
Najpierw ustal zakres wymaganej kolejności. Zwykle chodzi o zmiany jednego zamówienia, a nie o globalny porządek wszystkich zdarzeń sklepu. Jeśli kolejność jest konieczna, trzeba zapewnić sekwencjonowanie publikacji dla danego agregatu oraz odpowiedni routing i przetwarzanie po stronie brokera i konsumenta. Sam wybór wspólnego klucza partycji nie naprawi kolejności, którą wcześniej odwróciły workery.
Wersja agregatu pomaga wykryć starszy stan lub lukę w sekwencji. Przy pełnym obrazie stanu odbiorca może odrzucić starszą wersję. Przy przyrostach, takich jak „zwiększ saldo o 20”, pominięcie brakującej wiadomości da zły wynik. Potrzebujesz wtedy buforowania, ponowienia lub uzgodnienia brakujących danych.
Przejęcie pokazane wcześniej rozwiązuje współdzielenie pracy i odzyskiwanie rekordów. Obsługa kolejności dla agregatu wymaga dodatkowego mechanizmu; nie wynika z tego SQL-a.
Ponowienia, trudne wiadomości i retencja
Po przejściowej awarii zaplanuj kolejną próbę przez available_at. Stosuj rosnące opóźnienie z losowym rozrzutem, czyli jitter, i ustal górną granicę czasu oczekiwania. Zapobiega to jednoczesnemu uderzeniu wielu workerów w usługę, która właśnie wraca do działania.
Błędny kontrakt, zbyt duża wiadomość lub brak uprawnień do publikacji mogą wymagać interwencji. Po ustalonym progu prób odłóż rekord do stanu wymagającego obsługi i zaalarmuj operatora. Zachowaj jego identyfikator, przyczynę oraz możliwość kontrolowanego wznowienia. Oznaczenie takiej wiadomości jako opublikowanej ukryłoby utraconą pracę.
Retencję ustal dla obu stron. Usuwanie opublikowanych rekordów utrzymuje niewielką tabelę roboczą, ale ogranicza możliwość ponownej wysyłki. Usunięcie wpisów Inboxa pozwala bardzo starym duplikatom wykonać efekt ponownie. Okres przechowywania powinien uwzględniać retencję brokera, ręczne ponowienia i przywracanie systemów z kopii zapasowych.
Indeksy dopasuj do zapytania przejmującego rekordy i sprawdź plan na realistycznej liczbie wiadomości. W PostgreSQL częściowy indeks dla published_at IS NULL może ograniczyć przeszukiwany zbiór. Czyszczenie dużej tabeli prowadź małymi porcjami, z uwzględnieniem obciążenia bazy.
Jak zauważyć, że Outbox przestał działać
Sam działający proces workera nie oznacza, że wiadomości docierają do odbiorców. Monitoruj co najmniej:
- Wiek najstarszej nieopublikowanej wiadomości i liczbę rekordów gotowych do próby.
- Czas od zapisu do potwierdzenia publikacji, liczbę prób oraz błędy z podziałem na przyczynę.
- Wygasłe przejęcia, wiadomości wymagające interwencji i tempo przyrostu zaległości.
- Opóźnienie po stronie konsumenta oraz liczbę rozpoznanych duplikatów.
Odróżniaj opublikowanie wiadomości od wykonania operacji biznesowej. Potwierdzenie brokera nie dowodzi, że magazyn zarezerwował towar. Dla procesu zamówienia może być potrzebne osobne potwierdzenie, limit czasu i ścieżka obsługi braku odpowiedzi.
Łącz logi przez MessageId, identyfikator zamówienia i identyfikator korelacji. Logowanie całego payloadu bywa zbędne i może ujawniać dane klientów. Alert powinien prowadzić do konkretnej procedury: sprawdzenia błędu, przywrócenia konfiguracji i wznowienia pracy bez zmiany tożsamości wiadomości.
Testuj przerwania w niewygodnych miejscach
Test, w którym mock brokera przyjmuje wiadomość, obejmuje najłatwiejszą ścieżkę. Najwięcej informacji dają kontrolowane awarie na granicach:
- Rollback transakcji biznesowej: w bazie nie zostaje ani zmiana zamówienia, ani rekord outboxa.
- Restart po zatwierdzeniu zapisu: wiadomość zostaje znaleziona i wysłana przez kolejny proces.
- Przyjęcie przez broker bez zapisu potwierdzenia w SQL: ponowna publikacja zachowuje
MessageId, a konsument wykonuje efekt jeden raz. - Dwóch workerów i wygaśnięcie lease: przejęcie można odzyskać, a stary token nie pozwala nadpisać stanu nowego właściciela.
- Rollback i restart konsumenta: Inbox oraz efekt zapisują się atomowo, także przy równoczesnym dostarczeniu duplikatu.
- Dłuższa awaria i zmiana kolejności: system ogranicza tempo prób, alarmuje o zaległościach i zachowuje wymagane reguły sekwencji.
Blokady, unikalność, potwierdzenia publikacji i zachowanie po utracie połączenia sprawdź z rzeczywistym silnikiem bazy oraz brokerem. Testy jednostkowe przydają się do polityki ponowień i reguł biznesowych, ale nie odtworzą protokołu dostarczania.
Kiedy warto ponieść ten koszt
Outbox ma sens, gdy zatwierdzona zmiana biznesowa musi prowadzić do trwałego zlecenia dalszej pracy, a utraty pomiędzy bazą i odbiorcą nie można zaakceptować. Broker jest częstym odbiorcą, ale podobna potrzeba dotyczy webhooków i innych zewnętrznych wywołań. Dla pojedynczej operacji mieszczącej się w jednej lokalnej transakcji taki mechanizm może być zbędny.
Własny worker z pollingiem jest jednym z wariantów. Możesz wykorzystać bibliotekę implementującą outbox albo publikację opartą na CDC. Sprawdź wtedy, jak rozwiązanie obsługuje transakcję zapisu, restarty, duplikaty, kolejność i retencję. Przejęcie tych zadań przez narzędzie nadal wymaga poznania jego gwarancji.
Outbox nie wymaga Event Sourcingu. Źródłem prawdy mogą pozostać aktualne tabele, a wiadomości mogą zasilać projekcję opisaną w artykule CQRS bez Event Sourcingu. Odbudowa projekcji wymaga osobnego planu, zwłaszcza jeśli opublikowane rekordy outboxa zostały już usunięte.
Zacznij od atomowego zapisu danych i wiadomości. Następnie zapewnij odzyskiwanie pracy, stabilną tożsamość komunikatu oraz idempotentnego odbiorcę. Dopiero ten zestaw, razem z monitoringiem i procedurą naprawy, pozwala przejść od tabeli oczekujących rekordów do niezawodnej komunikacji.