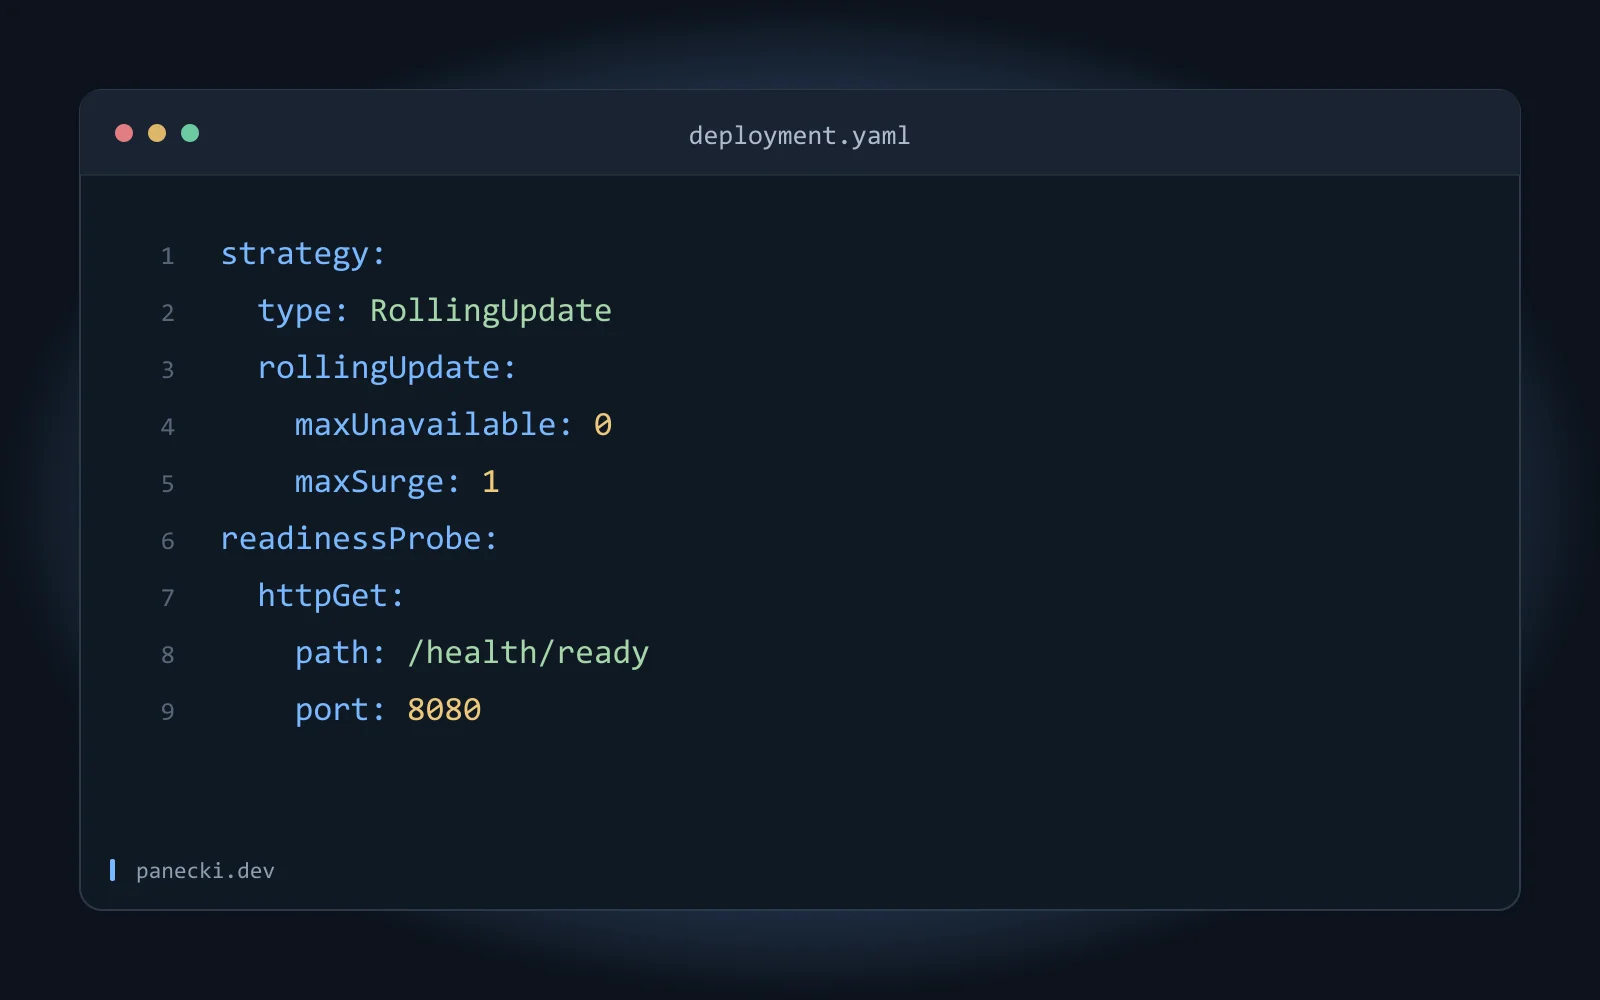
Zero-downtime deployment w Kubernetes nie wymaga zaawansowanych narzędzi. Wymaga trzech poprawnie skonfigurowanych elementów: readiness probe, strategii rolling update i pre-stop hooka.
Readiness probe to nie liveness probe
Liveness mówi „proces żyje, nie restartuj mnie". Readiness mówi „jestem gotowy przyjmować ruch". Pomylenie tych dwóch rzeczy to najczęstsza przyczyna krótkich przerw w działaniu przy wdrożeniu.
readinessProbe:
  httpGet:
    path: /health/ready
    port: 8080
  initialDelaySeconds: 5
  periodSeconds: 5
  failureThreshold: 3
Rolling update i pre-stop hook
Domyślna strategia rolling update jest bezpieczna, jeżeli ustawisz
maxUnavailable: 0. Sam hook preStop daje aplikacji czas
na dokończenie żądań już przyjętych, zanim proces dostanie SIGTERM.
Bez preStop i z krótkim terminationGracePeriodSeconds
zobaczysz błędy 502 dokładnie w momencie wdrożenia - i tylko wtedy, więc łatwo je
pomylić z problemem sieciowym.
Podsumowanie
Trzy elementy, jedna zasada: pod nie może zniknąć z load balancera wcześniej, niż przestanie przyjmować nowe żądania. Reszta to konfiguracja.